
Nella giornata del 18 novembre 2025, Cloudflare, uno dei più grandi fornitori di servizi online, ha registrato un down globale. Ciò ha generato a cascata interruzioni su siti e applicazioni che utilizzano i suoi servizi DNS e CDN. Infatti, in pochi minuti, si sono sono verificati errori di connessione, rallentamenti e blocchi completi che hanno colpito piattaforme pubbliche e private in più Paesi.
Sebbene alcuni fossero intermittenti, il loro effetto ha impattato immediatamente su migliaia di realtà che fanno uso delle sue funzioni essenziali. Tutto questo deriva dalla centralità che Cloudflare ricopre nella gestione del traffico e nella protezione di milioni di domini.
Ma come sempre, andiamo con ordine e affrontiamo per gradi l’argomento.
Cloudflare down in tutto il mondo
Intorno alle 12:20 italiane, Cloudflare ha rilevato un picco improvviso di traffico insolito su uno dei propri servizi. Alle 12:48 circa, l’azienda ha subito una degradazione interna, che ha provocato errori diffusi sulla rete di distribuzione dei contenuti e sui DNS. Nel giro di pochi minuti, utenti e amministratori di sistema in tutto il mondo hanno iniziato a segnalare una serie di disservizi ed errori di rete 500. A ciò si sommano anche interruzioni sulle proprie dashboard e le API di Cloudflare, insieme alle difficoltà di accesso a servizi esterni dipendenti.
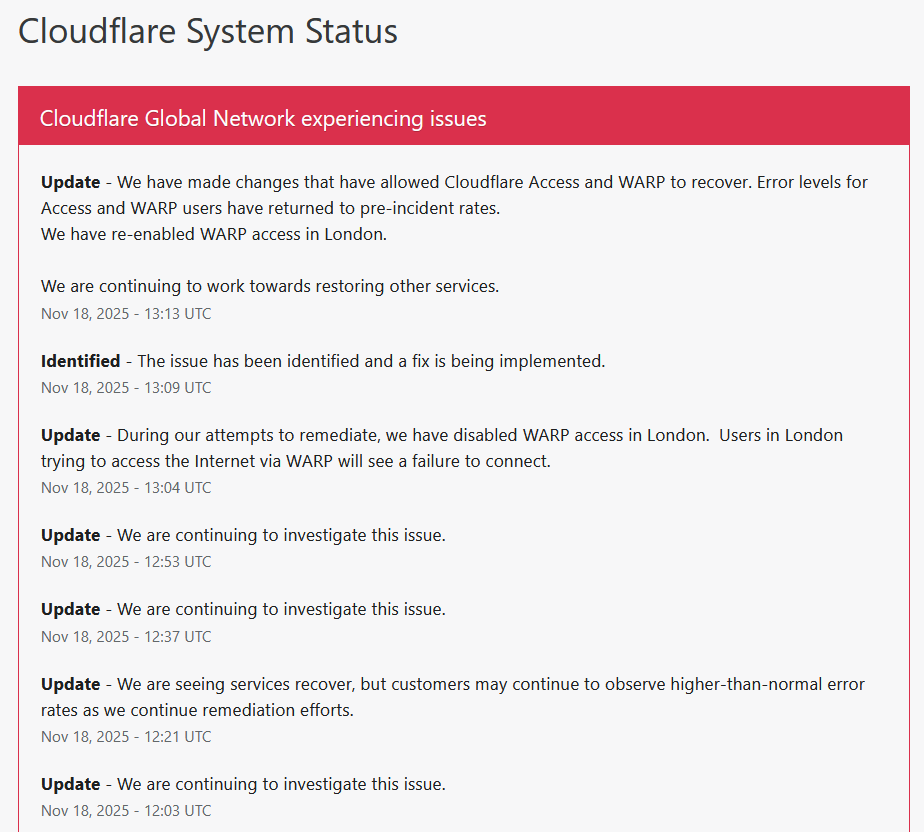
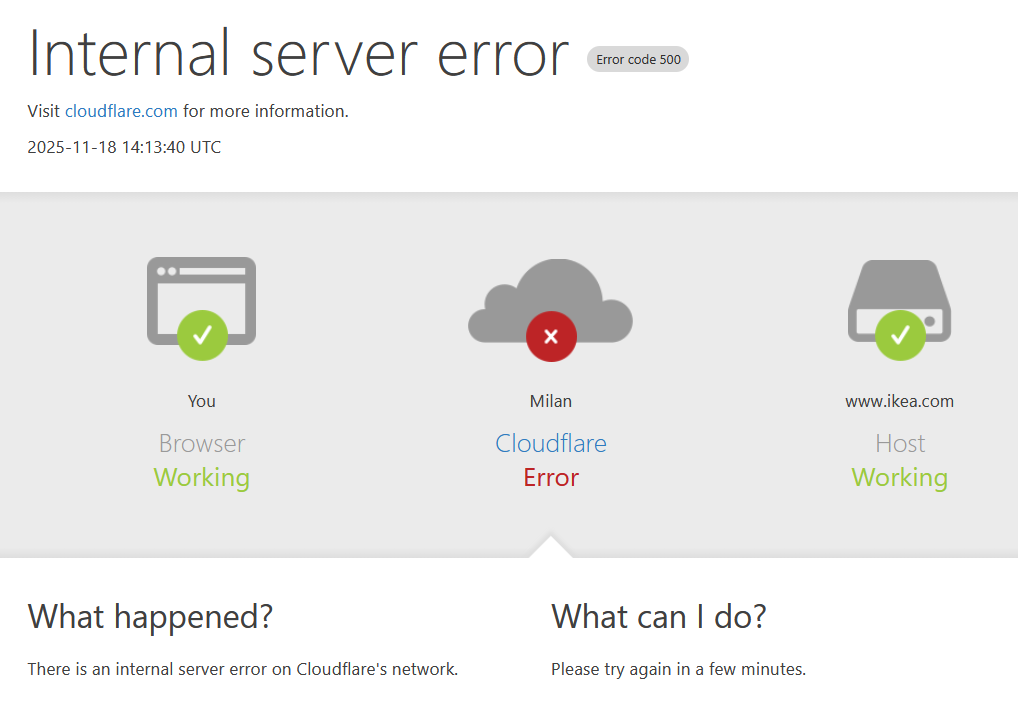
L’interruzione improvvisa ha coinvolto nello specifico la rete edge di Cloudflare, il resolver DNS pubblico, la protezione contro attacchi DDoS e il bilanciamento del traffico verso i clienti. In breve, migliaia di realtà hanno lamentato malfunzionamenti o non raggiungibilità dei servizi. In parallelo, in alcune regioni sono stati disattivati temporaneamente dei servizi come WARP, la connessione sicura di Cloudflare basata su VPN. Questo per consentire agli operatori interni di procedere con le operazioni di stabilizzazione.
Le segnalazioni dei disservizi sono rapidamente aumentate e la verifica dello stato ufficiale indicava che, pur essendo la maggior parte del traffico servito, si evidenziavano ritardi nel recupero della piena funzionalità. Tra le vittime accertate del down di Cloudflare si citano:
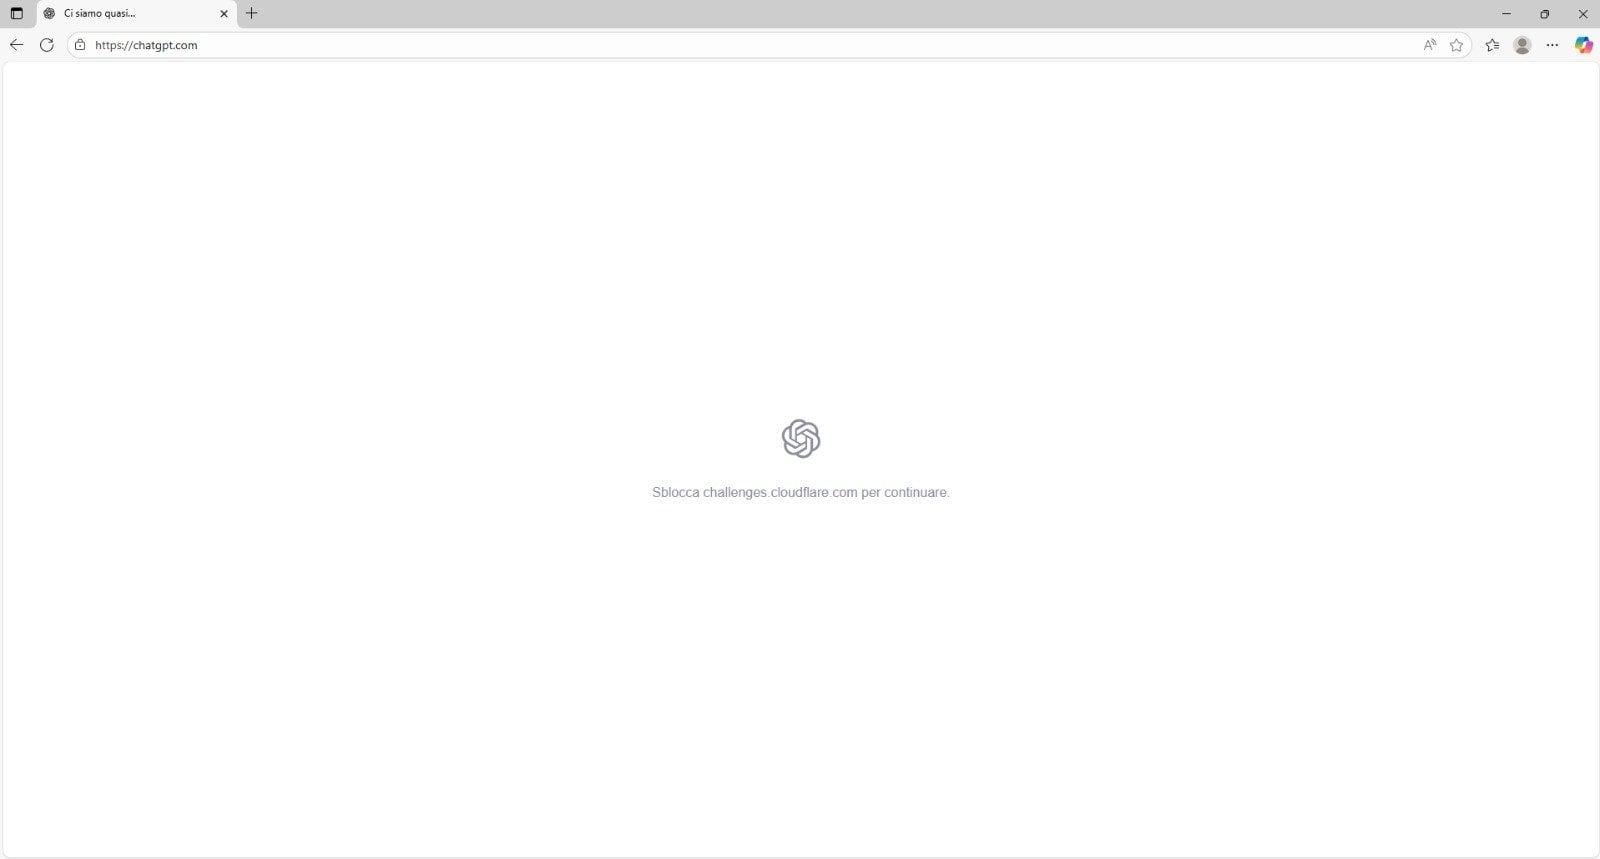
- ChatGPT
- X (ex Twitter)
- Canva
- Stack Overflow
- Genspark
- Moody’s Corporation
- Claude AI
- WordPress
- Indeed
- Codeforces
- NJ Transit
- Coinbase
- Quora
- Ikea
- League of Legends
- Challenges Cloudflare
Cause tecniche del down di cloudflare
Stando alle comunicazioni riportate sul portale Clouflare Status e le ricostruzioni della testata The Guardian, l’incidente è stato causato da un malfunzionamento interno nella gestione del traffico. Il sistema ha ricevuto un volume anomalo di richieste che ha attivato meccanismi automatici di protezione, i quali non hanno gestito correttamente la redistribuzione interna. Tuttavia, è bene chiarire che Cloudflare ha affermato che non si è trattato di un attacco.
Tutto il problema si è sviluppato nella logica di instradamento tra i nodi dell’infrastruttura CDN. Poiché il traffico anomalo ha superato le capacità dei sistemi coinvolti, una parte della rete ha iniziato a processare richieste con ritardi crescenti, mentre altri nodi hanno attivato condizioni di fallback non previste per quel volume.
La discrepanza tra le due parti della rete ha provocato una degradazione progressiva di diversi servizi, ma la natura dell’incidente è rimasta circoscritta a Cloudflare. L’azienda ha iniziato a registrare comportamenti anomali nei sistemi responsabili del trattamento delle richieste e del funzionamento ordinario dei singoli clienti.
Impatto su aziende e privati
Cloudflare è attualmente impiegato come fornitore di servizi DNS e CDN da milioni di realtà a livello mondiale. Secondo una stima, sono oltre 39 milioni i siti web che si affidano all’azienda californiana. Da ciò si evince la portata dell’interruzione, in quanto ha colpito non solo realtà internazionali e grandi piattaforme, ma soprattutto aziende di dimensioni medie e servizi locali.
Molte imprese che fanno affidamento esclusivo su Cloudflare per la visibilità online, la risoluzione DNS e la protezione da attacchi, si sono trovate senza alternative immediate. Oltre all’irraggiungibilità dei propri siti, sono stati estromessi anche i processi di login, la verifica antibot tramite captcha e i sistemi di pagamento.
Per queste realtà, anche un blocco della durata di pochi minuti può tradursi in perdita di fiducia da parte degli utenti, costi operativi aggiuntivi e interventi di emergenza sul piano tecnico e gestionale. Dal lato dei privati, l’interruzione è stata percepita come qualcosa di improvviso e generalizzato. Il fenomeno mette in evidenza che il rischio non riguarda solo chi utilizza attivamente certi servizi, ma anche chi ne dipende indirettamente.
Ridondanza senza diversificazione
L’incidente di Cloudflare dimostra come molte realtà stiano adottando un modello di ridondanza che solo in apparenza sembra solido. In realtà, questo non regge affatto, poiché il punto centrale dell’infrastruttura è unico. La pratica comune consiste nel distribuire copie dei servizi o dei dati su server diversi, che però dipendono tutti dallo stesso fornitore. In questo modo si crea una diversificazione apparente dei percorsi e delle tecnologie.
Quando un provider gestisce simultaneamente DNS, protezione dagli attacchi e distribuzione dei contenuti, tutti i suoi servizi convergono nello stesso nodo. Se questo cede, anche le copie ridondate smettono di funzionare, perché si appoggiano alla stessa infrastruttura. Lo abbiamo visto in precedenza con AWS di Amazon e oggi lo abbiamo rivisto con Cloudflare: segno che il problema riguarda il modello adottato su larga scala.
La falsa sensazione di sicurezza porta molte aziende a sottovalutare l’importanza di una ridondanza eterogenea basata su più provider. Diversificare i punti di risoluzione DNS e distribuire il traffico su reti differenti, permette di ridurre la dipendenza da un unico fornitore e di rendere l’infrastruttura più resistente ai guasti. Questa è l’unica direzione da seguire, se intendiamo dare vita a infrastrutture meno esposte a blackout improvvisi.
Articoli che potrebbero interessarti:
- Autore articolo
- Ultimi articoli

Classe 1993, ingegnere gestionale e Adobe Certified Professional in Graphic Design & Visual Design. Ho mosso i primi passi nel campo informatico grazie alla passione per i videogiochi, che mi ha portato ad approfondire i motori grafici e la progettazione visiva. Scrivo da quando ero bambino e, con il tempo, la scrittura è diventata parte integrante del mio lavoro nel mondo della comunicazione e della sicurezza informatica.